 Consulting
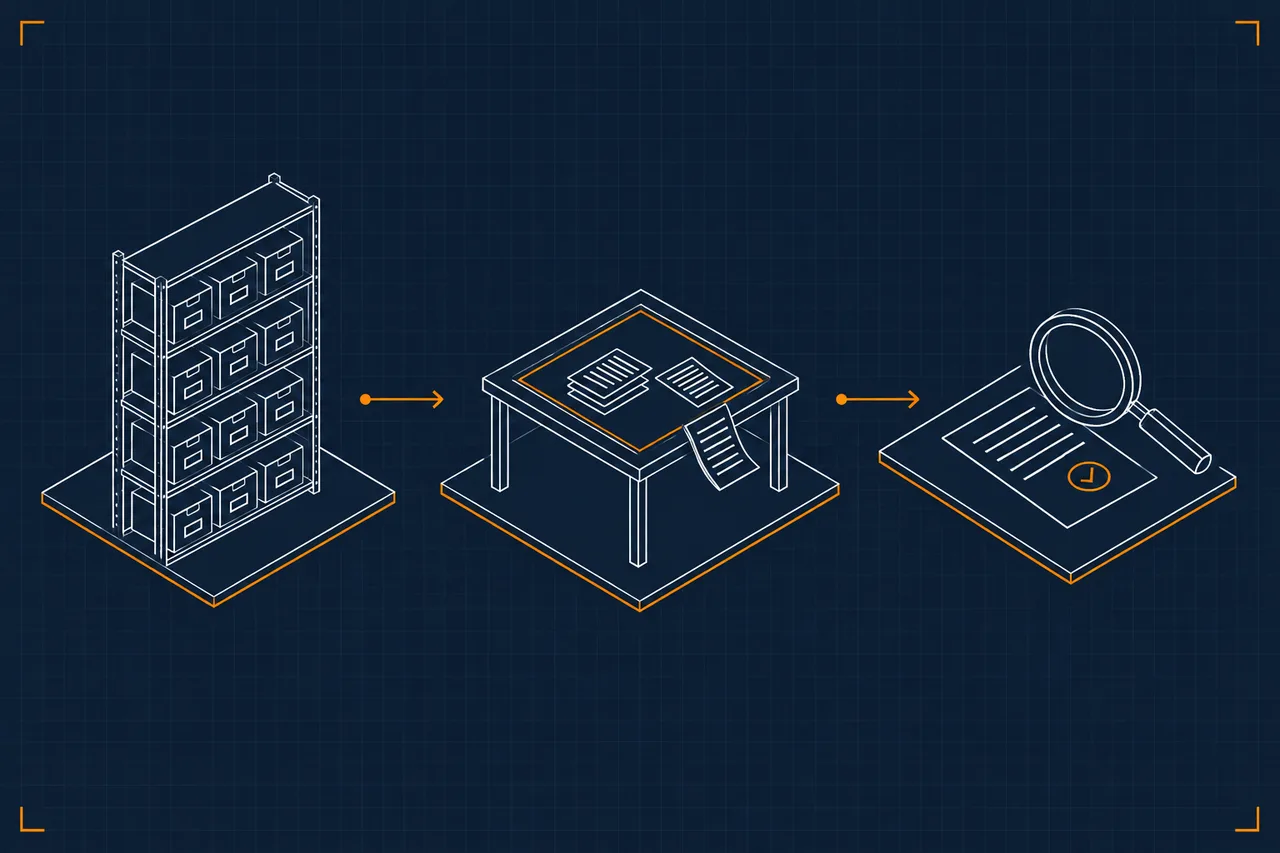
- Das Kontextfenster ist alles, was ein KI-Modell bei einer Antwort gleichzeitig sieht: Anweisungen, Gesprächsverlauf, Dokumente und deine Frage, gemessen in Tokens.
- Ein Sprachmodell lernt nicht aus deinem Chat. Was nicht im Fenster steht, kennt es nicht. Wird das Fenster voll, fallen alte Teile heraus oder werden gekürzt.
- Auch ein großes Fenster hilft nur begrenzt: Studien zeigen, dass Modelle Informationen in der Mitte langer Texte schlechter nutzen und mit wachsender Länge ungenauer werden.
- Gegenmittel: destillierte Daten (kurz, gültig, eindeutig), semantische Suche (holt nur die passenden Abschnitte) und eine Daten- und Infrastruktur, die das zuverlässig erledigt.
Warum KI vergisst
Fast jeder, der regelmäßig mit ChatGPT, Claude oder Gemini arbeitet, kennt das: Am Anfang legst du fest, dass die Antworten in Du-Form und ohne Fachchinesisch kommen sollen. Eine Stunde später siezt dich die KI wieder, hat die Preisliste vom Anfang vergessen oder widerspricht einer Entscheidung, die ihr gemeinsam getroffen habt.
Das ist kein Fehler im Programm, sondern eine Eigenschaft aller großen Sprachmodelle. Der Grund heißt Kontextfenster. Wer verstanden hat, wie es funktioniert, versteht auch, warum eine KI im Unternehmen nicht einfach mit allen Dokumenten gefüttert werden kann, und was stattdessen nötig ist.
Was ist ein Kontextfenster?
Das Kontextfenster (englisch context window) ist alles, was ein KI-Modell bei einer einzelnen Antwort gleichzeitig sehen kann. Stell es dir wie einen Arbeitstisch vor: Was auf dem Tisch liegt, kann die KI lesen und nutzen. Was nicht darauf liegt, existiert für sie in diesem Moment nicht.
Auf diesem Tisch liegen bei jeder Antwort:
- Anweisungen im Hintergrund: was der Anbieter oder du als feste Regeln hinterlegt hast.
- Der bisherige Gesprächsverlauf: jede Frage und jede Antwort, die bisher im Chat stand.
- Eingefügte Inhalte: Dokumente, Tabellen, Webseiten, Notizen aus der Gedächtnisfunktion.
- Deine aktuelle Frage und die Antwort, die gerade entsteht.
Wichtig: Das Modell lernt aus deinem Gespräch nichts dauerhaft dazu. Es liest bei jeder Antwort den ganzen Tisch neu. Ein neuer Chat ist ein leerer Tisch.
Was sind Tokens?
Gemessen wird das Kontextfenster in Tokens. Ein Sprachmodell liest keine Buchstaben und keine ganzen Sätze, sondern zerlegt Text in Bausteine: häufige Wörter als ein Token, seltene oder lange Wörter in mehrere Teile. Ein Wort wie „Auftragsbestätigung“ besteht aus mehreren Tokens. Deutsche Texte brauchen deshalb meist mehr Tokens als englische mit gleichem Inhalt.
Tokens bestimmen zwei Dinge: wie viel auf den Tisch passt und was eine Anfrage kostet. Wer über eine Schnittstelle mit KI arbeitet, bezahlt nach Tokens, für die Eingabe und für die Antwort. Die Größe der Fenster ist in den letzten Jahren stark gewachsen, aktuelle Modelle verarbeiten je nach Anbieter und Tarif ganze Bücher auf einmal. Am Grundproblem ändert das weniger, als man denkt.
Drei Gründe für die Vergesslichkeit
- Der Tisch ist voll. Wird ein Gespräch zu lang, muss Platz geschaffen werden. Je nach Anwendung werden ältere Teile abgeschnitten oder automatisch zusammengefasst. In der Zusammenfassung fehlen Details, oft genau die, die dir wichtig waren.
- Die Mitte geht unter. Ein Forschungsteam um Nelson F. Liu hat 2023 gezeigt, dass Sprachmodelle Informationen am Anfang und am Ende eines langen Textes deutlich besser nutzen als in der Mitte („Lost in the Middle“). Eine Regel, die irgendwo im Verlauf steht, wird leichter übersehen.
- Mehr Text, mehr Rauschen. Eine Untersuchung des Datenbank-Anbieters Chroma von 2025 hat 18 Modelle getestet: Mit wachsender Eingabelänge wurden die Antworten unzuverlässiger, auch bei einfachen Aufgaben, die weit unter der maximalen Fenstergröße lagen. Dafür hat sich der Begriff Context Rot eingebürgert, sinngemäß „der Kontext verdirbt“.
Dazu kommt ein vierter, ganz praktischer Grund: Widersprüche. Liegen auf dem Tisch eine alte und eine neue Preisliste, weiß die KI nicht, welche gilt. Sie nimmt mal die eine, mal die andere. Das wirkt wie Vergessen, ist aber ein Datenproblem. Wie solche Fehler zu erfundenen Antworten führen können, beschreibt der Artikel KI-Risiken im Unternehmen.
Warum „einfach alles hineinkippen“ nicht funktioniert
Die naheliegende Idee: Wenn das Fenster groß genug ist, laden wir einfach alle Handbücher, Preislisten und Kundenvorgaben hoch. Das scheitert aus drei Gründen. Erstens passt das Wissen eines Unternehmens auch in große Fenster nicht vollständig hinein. Zweitens wird die KI bei langen Eingaben ungenauer, siehe oben. Drittens kostet jede Anfrage dann viel Zeit und Geld, weil das Modell bei jeder Antwort alles neu liest.
Alles hineinkippen
Fenster voll: Alter Verlauf wird gekürzt, Regeln aus der Mitte gehen unter, alte und neue Fassungen widersprechen sich.
Gezielt holen
Viel Platz frei: Die semantische Suche holt nur die drei passenden Abschnitte aus der Wissensdatenbank, jeweils in der gültigen Fassung.
- Feste Regeln
- Gesprächsverlauf
- Ganze Dokumente
- Passende Abschnitte
- Frage
- Wird gekürzt oder fällt heraus
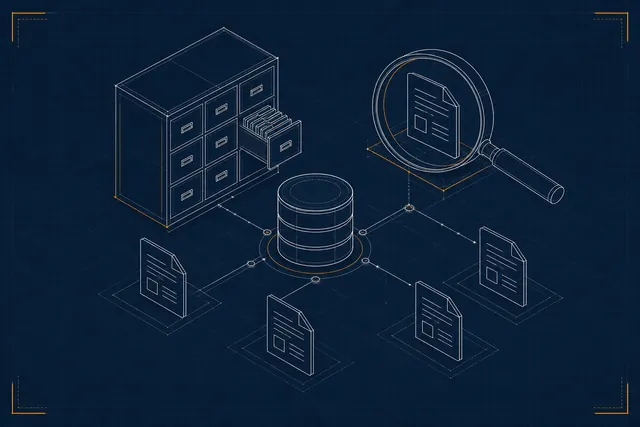
Der bessere Weg dreht das Prinzip um: Das Wissen liegt nicht auf dem Tisch, sondern im Lager. Bei jeder Frage holt jemand genau die Teile, die gebraucht werden. Dafür braucht es drei Dinge.
1. Destillierte Daten
Destilliert heißt: Aus vielen langen Quellen wird das Wesentliche herausgezogen und in eine kurze, eindeutige Form gebracht. Statt eines 80-seitigen Handbuchs gibt es zum Beispiel ein Faktenblatt pro Produkt, statt zwanzig E-Mails zu einem Kunden eine Seite mit allen gültigen Vorgaben.
- Kurz: ein Thema pro Dokument, klare Abschnitte, die auch einzeln verständlich sind.
- Gültig: genau eine aktuelle Fassung, mit Datum. Alte Stände wandern ins Archiv.
- Eindeutig: Zahlen, Namen und Regeln ausgeschrieben, keine Verweise wie „siehe oben“ oder „wie besprochen“.
- Gepflegt: Jemand ist zuständig und aktualisiert das Dokument, wenn sich etwas ändert.
Destillierte Daten sind gut für die KI und für Menschen. Wer neu ins Team kommt, findet sich in denselben Faktenblättern zurecht. Wie du Wissen grundsätzlich erfasst, steht im Artikel Prozessdokumentation, wie es aus den Köpfen erfahrener Mitarbeitender kommt, im Artikel Wissenstransfer im Unternehmen.
2. Semantische Suche
Eine klassische Suche findet Dokumente, in denen genau deine Wörter vorkommen. Die semantische Suche findet Inhalte nach ihrer Bedeutung. Fragt jemand nach „Lieferzeit für Sonderanfertigungen“, findet sie auch den Abschnitt über „Fertigungsdauer bei kundenspezifischen Werkzeugen“.
Technisch funktioniert das so: Jeder Abschnitt deiner Wissensdatenbank wird in eine Zahlenreihe umgerechnet, ein sogenanntes Embedding. Abschnitte mit ähnlicher Bedeutung bekommen ähnliche Zahlen. Gespeichert werden sie in einer Vektordatenbank. Bei einer Frage wird auch die Frage umgerechnet, und die Datenbank liefert die Abschnitte mit der größten Ähnlichkeit. Nur diese landen im Kontextfenster.
Dieses Zusammenspiel aus Suche und Antwort heißt im Fachjargon Retrieval Augmented Generation (RAG). Der Vorteil: Die KI arbeitet mit wenig, aber passendem Text, kann ihre Quelle nennen, und Änderungen in der Wissensdatenbank wirken sofort. In der Praxis wird die semantische Suche oft mit einer klassischen Stichwortsuche kombiniert, damit auch Artikelnummern und Fachbegriffe zuverlässig gefunden werden.
Ein Innendienst beantwortet Fragen zu Kundenvorgaben. Variante 1: Bei jeder Frage werden alle Vorgaben-Dokumente des Kunden mitgeschickt, rund 120.000 Tokens. Variante 2: Die semantische Suche holt die drei passenden Abschnitte, zusammen mit Regeln, Frage und Antwort rund 6.000 Tokens.
Ersparnis: 95 % weniger Text pro Anfrage, entsprechend geringere Kosten und schnellere Antworten
Beispielwerte zur Veranschaulichung, keine Ergebnisgarantie. Der größere Gewinn ist oft nicht der Preis, sondern die Genauigkeit: Die KI muss die richtige Vorgabe nicht mehr in einem Berg von Text suchen.
3. Gute Daten- und Infrastruktur
Destillierte Daten und semantische Suche funktionieren nur, wenn das Drumherum stimmt. Damit ist kein Großprojekt gemeint, sondern ein paar klare Grundlagen:
- Eine Wissensdatenbank als zentrale Quelle: Wissen liegt an einem Ort mit klarer Struktur, nicht verteilt über Postfächer, Laufwerke und Chatverläufe. Mehr dazu im Artikel Wissensmanagement im Unternehmen.
- Automatische Aktualisierung: Ändert sich ein Dokument, wird auch sein Eintrag in der Suche erneuert. Sonst findet die KI veraltete Fassungen.
- Schnittstellen: Aktuelle Zahlen wie Lagerbestand oder Auftragsstatus holt die KI direkt aus dem System, statt sie aus einer alten Tabelle abzulesen.
- Rechte: Die Suche liefert nur Inhalte, die die fragende Person auch im Original sehen darf.
- Hosting nach Datenart: Wo Embeddings und Dokumente liegen, richtet sich nach ihrer Vertraulichkeit. Die drei Wege vom Cloud-Dienst bis zum eigenen Server vergleicht der Artikel KI implementieren.
So gehen wir selbst mit dem Kontextfenster um
Ich arbeite täglich mit KI-Agenten an Websites, Blogartikeln und Kundenprojekten. Auch dort ist das Kontextfenster die Grenze, deshalb sind meine Projekte so aufgebaut:
- Ein kurzer Projektstand zum Start: Jede Sitzung beginnt mit einer Zusammenfassung von höchstens 120 Zeilen: was läuft, was offen ist. Ältere Einträge wandern unverändert in ein Archiv, das nur bei Bedarf gelesen wird.
- Feste Regeln an einem Ort: Tonalität, verbotene Formulierungen und Freigaben stehen in einer Regeldatei, die immer geladen wird, nicht irgendwo im Gesprächsverlauf.
- Wissen in Themendateien: Positionierung, Kundenfälle oder Keyword-Recherchen liegen in eigenen Dateien und werden nur geladen, wenn die Aufgabe sie braucht.
- Abschluss mit Destillat: Am Ende jeder Sitzung werden neue Erkenntnisse in die passenden Dateien übertragen, statt im Verlauf zu verschwinden.
So startet jede neue Sitzung mit einem fast leeren Tisch, auf dem genau das Richtige liegt. Wie ein solcher Ablauf als KI-Agent aussieht, zeigt der Artikel KI-Agent erstellen, das Prinzip dahinter der Artikel Second Brain für Unternehmen.
Tipps für den Alltag mit ChatGPT und Co.
- Neues Thema, neuer Chat. Lange Chats über viele Themen sind der schnellste Weg zum Vergessen.
- Feste Regeln fest hinterlegen. Nutze Projekt- oder Assistenten-Anweisungen statt die Regeln am Anfang eines Chats zu schreiben. Wie das geht, steht im Artikel KI-Assistent erstellen.
- Zwischenstände zusammenfassen lassen. Lass dir nach einer langen Arbeitsphase das Ergebnis in wenigen Punkten zusammenfassen und starte damit einen neuen Chat.
- Wichtiges ans Ende. Bei langen Eingaben die entscheidende Anweisung am Ende wiederholen, dort wird sie am besten beachtet.
- Nur gültige Dokumente hochladen. Keine alten Fassungen, keine Dubletten.
Welche Daten du dabei in welches Werkzeug geben darfst, regelst du in einer KI-Richtlinie. Hinweise zum Datenschutz in diesem Artikel sind keine Rechtsberatung.
Fazit
KI vergisst nicht aus Schlamperei, sondern weil sie nur sieht, was im Kontextfenster liegt, und weil sie in langen Texten den Überblick verliert. Ein größeres Fenster verschiebt das Problem nur. Die Lösung liegt im Umgang mit Wissen: destillierte Daten, die kurz, gültig und eindeutig sind, eine semantische Suche, die bei jeder Frage genau die passenden Abschnitte holt, und eine Daten- und Infrastruktur, die das zuverlässig und mit den richtigen Rechten erledigt. Dann arbeitet deine KI mit einem aufgeräumten Tisch und einem gut sortierten Lager dahinter.
Häufige Fragen
Was ist ein Kontextfenster?
Das Kontextfenster ist die Menge an Text, die ein KI-Modell bei einer einzelnen Antwort gleichzeitig verarbeiten kann. Dazu gehören die Anweisungen im Hintergrund, der bisherige Gesprächsverlauf, eingefügte Dokumente, deine Frage und die Antwort selbst. Gemessen wird es in Tokens.
Was sind Tokens bei KI?
Tokens sind die Bausteine, in die ein Sprachmodell Text zerlegt. Ein Token ist meist ein Wort oder ein Wortteil. Deutsche Wörter sind oft länger und zusammengesetzt, deshalb braucht deutscher Text in der Regel mehr Tokens als englischer. Nach Tokens richten sich sowohl die Größe des Kontextfensters als auch die Kosten pro Anfrage.
Warum vergisst ChatGPT, was ich am Anfang gesagt habe?
Weil lange Gespräche das Kontextfenster füllen. Dann werden ältere Teile gekürzt, zusammengefasst oder fallen ganz heraus. Selbst wenn sie noch im Fenster stehen, beachtet das Modell Angaben aus der Mitte langer Texte oft schlechter. Wichtige Regeln gehören deshalb in feste Anweisungen oder in eine Wissensdatenbank, nicht nur an den Anfang eines langen Chats.
Hilft ein größeres Kontextfenster gegen das Vergessen?
Nur teilweise. Ein größeres Fenster passt mehr Text, aber Modelle werden mit sehr langen Eingaben ungenauer, langsamer und teurer. Besser ist es, nur die Informationen ins Fenster zu holen, die für die aktuelle Aufgabe gebraucht werden.
Was ist semantische Suche?
Semantische Suche findet Inhalte nach ihrer Bedeutung statt nach exakt gleichen Wörtern. Wer nach Lieferzeit für Sonderanfertigungen fragt, findet auch einen Abschnitt, in dem von Fertigungsdauer bei kundenspezifischen Werkzeugen die Rede ist. Technisch werden Texte dafür in Zahlenvektoren, sogenannte Embeddings, umgewandelt und in einer Vektordatenbank gespeichert.
Was ist der Unterschied zwischen Kontextfenster und Gedächtnisfunktion?
Die Gedächtnisfunktion mancher KI-Apps speichert kurze Notizen über dich, etwa deinen Beruf oder bevorzugte Formate, und fügt sie in neue Chats ein. Diese Notizen landen ebenfalls im Kontextfenster. Sie ersetzen keine Wissensdatenbank, weil sie kurz, unstrukturiert und nicht für das ganze Team gedacht sind.
Maschinenbauingenieur mit Master in Kunststofftechnik und MBA, sieben Jahre Team- und Abteilungsleitung in der Industrie. Seit 2019 baut er digitale Vertriebs-, Schulungs- und KI-Systeme. Mehr über Fabian
Quellen
Dieser Beitrag wurde mit KI-Unterstützung erstellt.